
Método de Inspeção GEO em 8 Camadas
Método auditável que verifica, do servidor até a citação por IA, se um site é recebido, entendido, indexado e recomendado por buscadores, assistentes e agentes de IA.
- Código
- MET-BA-GEO8-001
- Versão
- 3.1.0
- Situação
- Vigente
- Vigência
- 17/10/2026
- Próxima revisão
- 17/04/2027
NOTA TÉCNICA: Todas as informações contidas aqui retratam a minha experiência e o meu método de trabalho, você é o total responsável por alterações no seu site ou no site de seus clientes. Nos responsabilizamos exclusivamente em parcerias formalizadas por contratos. Em dúvida, visite o Aviso Legal.
O Método de Inspeção GEO em 8 Camadas, de Felipe C. Ferreira, é um método auditável que verifica, do servidor até a citação por IA, se um site é recebido, entendido, indexado e recomendado por buscadores, assistentes e agentes de IA, com critério, fonte, limite e evidência datada em cada camada.
Ele junta SEO (otimização para buscadores), GEO (otimização para motores generativos, os assistentes que respondem com IA) e AEO (otimização para respostas). Cobre o SEO técnico de sempre (servidor, HTML, metadados) e o que passou a pesar com a IA: schema e entidades, grafo interno, acesso de agentes e citação em respostas. Uso a mesma régua no meu site e nas consultorias.
Para Quem Este Método Serve
Serve para o dono de empresa, o gestor de marketing e o time técnico que precisam responder a uma pergunta simples:
O meu site está sendo lido, entendido e citado, ou eu estou pagando por conteúdo que nenhuma máquina recebe?
Também serve para quem presta o serviço. Cada camada traz o passo a passo da inspeção, com o que conferir, a ferramenta, o limite e a evidência a guardar. Outra pessoa consegue repetir a inspeção e chegar ao mesmo status.
Este documento não é checklist de plugin e não promete posição no Google nem citação garantida em nenhum assistente. Ele mede o que dá para medir, com data, e mostra o que ainda está pendente.
Por Que o Trabalho É Organizado em Camadas
O robô (de busca ou de IA) passa pela camada de baixo antes de chegar à de cima. Se a CDN ou o servidor barram a requisição, não importa o quão bom é o schema: a página não chegou.
Por isso a ordem é fixa, do servidor até a resposta da IA. C quer dizer camada: C1 a C8 são os códigos deste método e não se confundem com os códigos L0 a L7 do Protocolo.
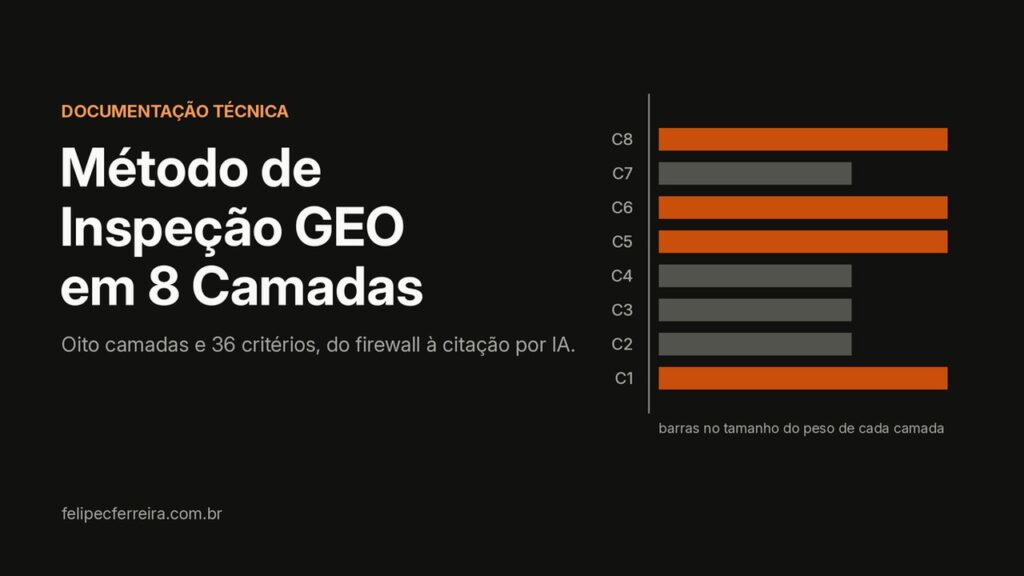
| Código | Camada | Peso | O que responde |
|---|---|---|---|
| C1 | CDN e firewall | 15 (trava) | O robô recebe a página? |
| C2 | Servidor e desempenho | 10 | Recebe rápido e com cache? |
| C3 | HTML e acessibilidade | 10 | O que chega está bem estruturado? |
| C4 | Metadados | 10 | Title, description, canonical e og contam a mesma história? |
| C5 | Schema e entidades | 15 | A máquina entende quem é o autor, o negócio e a oferta? |
| C6 | Grafo e links internos | 15 | As páginas se ligam e o robô alcança todas? |
| C7 | Acesso por agentes de IA | 10 | robots.txt, llms.txt e OKF liberam e respondem? |
| C8 | Indexação e citação por IA | 15 (10 + 5) | Está no índice e aparece nas respostas? |
Na prática, eu começo de baixo. Inspecionar C5 antes de saber se o C1 está aberto é gastar hora técnica no lugar errado. E hora técnica no lugar errado é a conta que não fecha..
Este método se apoia no Protocolo L0 : L7, que é a setorização da nossa operação. O Protocolo diz em qual camada técnica o problema mora (negócio, infraestrutura, entrega, dados, aplicação, interface, operação e segurança). O Método de Inspeção mede a visibilidade em busca e IA. São documentos separados, com códigos próprios.
Atenção aos códigos: no Protocolo, L1 é “Infraestrutura e Ambiente”. Neste método, C1 é “CDN e firewall”. Por isso os códigos são diferentes.
Quem Acessa o Seu Site: os Tipos de Acesso por Máquina
Antes das camadas, uma pergunta que muda a leitura de todo o resto: quem, exatamente, está pedindo as suas páginas? Não é um robô só. São tipos diferentes de acesso, e cada um enxerga uma coisa.
| Tipo de acesso | Exemplos | O que recebe e executa | O que muda no método |
|---|---|---|---|
| Crawler (índice, busca ou treino) | GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot | O HTML que o servidor entrega. Numa medição da Vercel (dez/2024), os robôs da OpenAI, da Anthropic, da Meta, da ByteDance e da Perplexity não renderizaram JavaScript | C1 (chegam sem bloqueio?), C3 (conteúdo no HTML do servidor), C7 (robots.txt, llms.txt) |
| Fetcher acionado pelo usuário | ChatGPT-User, Claude-User, Perplexity-User | Uma página pedida na hora, porque alguém perguntou algo ao assistente. Na mesma medição, o ChatGPT-User também não renderizou JavaScript | C1 e C3; aparecem nos logs da CDN, não no GA4 |
| Robô de busca que renderiza | Googlebot; Bingbot | O Googlebot põe na fila de renderização as páginas com status 200 e roda o JavaScript quando há recurso, o que pode levar de segundos a mais tempo. O Bing diz que conteúdo que não renderiza de forma confiável pode não ser indexado | C3 (status correto e conteúdo no HTML continuam valendo), C4, C8 |
| Agente com navegador | O navegador na nuvem do ChatGPT (antigo ChatGPT agent), que assina as requisições | Um navegador de verdade: carrega a página, roda o JavaScript e interage com botões e formulários | C3: HTML semântico e acessibilidade ajudam o agente a achar o que clicar (recomendação minha, de engenharia); C1: o firewall não pode barrar o agente assinado |
| Automação headless | Scripts com navegador sem interface, ferramentas de teste e de coleta | Depende de quem programou: pode ou não rodar JavaScript e pode ou não se identificar | C1 (bots falsos filtrados na borda); nunca conta como bot verificado |
| Clique humano vindo de uma resposta de IA | Uma pessoa clica no link citado pelo ChatGPT, pelo Perplexity ou pelo Copilot | A página completa, num navegador comum | Consequência, não causa: sinal complementar no GA4, fora da nota |
O que isso decide no método:
- O critério sem JavaScript da C3 fica. Crawlers e fetchers leem o HTML do servidor. A versão para máquina da C7 complementa, não substitui.
- HTML semântico e acessibilidade (C3) importam também para agentes com navegador. Um agente que opera a página precisa de botões, rótulos e estrutura claros. Isso é recomendação minha, de engenharia; não há métrica pública de quanto pesa.
- O GA4 fica fora da nota. Ele mede por uma tag JavaScript no navegador: crawlers e fetchers que não executam JavaScript não disparam a tag, e por isso não aparecem. O filtro de bots conhecidos do GA4 usa pesquisa do Google e a lista internacional de robôs do IAB, e não dá para ver quanto foi excluído. Dizer que esse filtro deixa passar agentes com navegador, contando-os como pessoas, é inferência minha, não afirmação da documentação.
- Limitação dos agentes assinados. No plano Free da Cloudflare, desde 01/07/2026, agentes assinados entram na mesma contagem dos bots verificados, e separar exige o plano Enterprise. A régua mede a contagem conjunta e não promete separar.
- User-agent sozinho não prova nada. Só conta como robô verificado o que a CDN (ou o DNS reverso nos logs) confirmou. Por isso as camadas C1, C6 e C7 usam bots verificados.
Como Usar Este Documento
Cada camada segue sempre a mesma estrutura de 7 partes:
- O que inspecionamos: o escopo da camada.
- Por que importa para o negócio: onde isso pesa no caixa.
- Como medimos: fonte, métrica, limite e o passo a passo reproduzível.
- Critérios: o que é Aprovado, Parcial e Pendente.
- Como está no nosso site: status, data e o que mudou (com registro no histórico de versões).
- Evidência autoral: o que eu construí para medir ou corrigir. Sempre projeto proprietário, não comercializado e sem código público.
- Conteúdos que aplicam esta camada: posts e documentos do site.
Para auditar um site, siga as camadas na ordem, registre cada critério no modelo de evidência abaixo e só depois calcule a nota.
Modelo de registro de evidência
Todo critério inspecionado gera um registro com estes campos. Sem registro, o critério não entra na nota.
| Campo | O que preencher |
|---|---|
| Critério | Camada e nome do critério (ex.: C1, crawlers de IA verificados sem 429) |
| Data e hora | Com fuso (ex.: 13/10/2026 09:30 BRT) |
| Janela | Período dos dados (ex.: 28 dias fechados) |
| Fonte | Ferramenta ou base (CDN, crawl dos sitemaps, Search Console etc.) |
| Origem do dado | Coletado por nós na fonte, ou “enviada pelo cliente” |
| Método | Consulta, comando ou teste usado, copiado na íntegra |
| Resultado bruto | Arquivo ou print guardado, com nome e data |
| Valor | Número medido, com numerador e denominador |
| Status | Aprovado, Parcial ou Pendente, pelo limite da camada |
| Ressalva | Amostragem, cota, bloqueio, o que não foi possível medir |
| Quem inspecionou | Nome ou função |
Critério pela função, não pela marca
Cada critério mede uma função, não um fornecedor. “CDN e firewall” é uma camada fundamental com qualquer fornecedor. A Cloudflare é o que eu uso, é a boa prática que eu recomendo e é o meu estudo de caso. Outra CDN, outro firewall ou os logs do próprio servidor com o mesmo dado valem igual.
Quem não tem a função, ou não libera o acesso a ela, fica com o critério em Pendente (0), exibido como “a medir”. Não existe “não se aplica”: um site sem CDN não está dispensado da camada, está sem a proteção que ela mede. Nesse caso, eu recomendo, ajudo a configurar ou executo a configuração da Cloudflare.
Como eu acesso os dados do cliente
A régua é a mesma do meu site. O que muda é o acesso, e são dois modelos:
- Preferido: um usuário provisório, só de leitura, com o meu e-mail, nas plataformas do cliente (Search Console, CDN, hospedagem, WordPress e o que mais a inspeção pedir). Eu coleto na fonte.
- Alternativo: um colaborador autorizado do cliente me envia os dados brutos (exportação CSV ou JSON com data, no formato que eu passo). Print e resumo não valem. Essa evidência é marcada como “enviada pelo cliente”, e eu deixo claro: não respondo pela idoneidade de um dado que eu não coletei na origem, porque ele pode chegar recortado ou enviesado.
Todo acesso é combinado por escrito: escopo só leitura, prazo de retenção, LGPD e permissão para testes de simulação de robôs.
Inspeção só com dado público é outro produto
Sem acesso às contas do cliente, eu consigo medir uma parte das camadas com dado público. Isso não é este método: é um diagnóstico inicial de prospecção, com nome próprio e com a cobertura declarada ao lado do resultado. A inspeção profissional é a que tem acesso às fontes.
Como Funciona a Nota
Resumo curto. A atribuição completa da nota (fórmula, pesos, percentuais, limites de cada critério e de onde eles vieram) está na página Como a Nota do Método de Inspeção GEO é Atribuída.
- Status do critério: Aprovado vale 100, Parcial vale 50 e Pendente vale 0. Critério ainda sem medição conta como Pendente (0) e aparece como “a medir”.
- Nota da camada: média dos critérios da camada. Cada critério tem o mesmo peso dentro da camada, e eu publico quantos pontos ele vale na nota global.
- Nota global: soma de (peso da camada × nota da camada), dividida por 100. Pesos: C1 15, C2 10, C3 10, C4 10, C5 15, C6 15, C7 10 e C8 15 (indexação 10 + citação por IA 5). Somam 100.
- Critérios por camada (36 no total) e pontos efetivos de cada um na nota global:
| Camada | Peso | Critérios | Pontos por critério |
|---|---|---|---|
| C1 | 15 | 5 | 3,00 |
| C2 | 10 | 3 | 3,33 |
| C3 | 10 | 4 | 2,50 |
| C4 | 10 | 5 | 2,00 |
| C5 | 15 | 7 | 2,14 |
| C6 | 15 | 6 | 2,50 |
| C7 | 10 | 4 | 2,50 |
| C8 indexação | 10 | 1 | 10,00 |
| C8 citação por IA | 5 | 1 | 5,00 |
- O que fica fora da nota: o GA4 e o desempenho orgânico. A nota mede se as máquinas acessam, entendem, indexam e citam o site. O GA4 mede a visita humana, que é consequência, não causa. Os dois entram como sinal complementar e como recomendação.
- Sem dupla contagem: redirecionamentos aparecem na C3 (a URL publicada no sitemap) e na C6 (o link do corpo que aponta para ela). São objetos diferentes, e não existe critério de redirecionamento separado. O “status 200” das URLs do sitemap fica só na C3; a C4 olha só noindex e canonical.
- Trava do C1: enquanto o INS-01 estiver aberto, a nota global fica limitada a 70, mesmo que a conta dê mais. Uma nota alta com o C1 bloqueado venderia uma visibilidade que não acontece.
Exemplo com número real (C5, linha de base de 12/10/2026): 7 critérios, 2 Aprovados e 5 Parciais. (2 × 100 + 5 × 50) ÷ 7 = 64,3. Com peso 15, a C5 contribui com 9,6 pontos na nota global.
Esta régua não é universal. Ela nasceu de documentação de referência, de conhecimento técnico e da minha visão de engenharia, como responsável pelo método. Não é validada pelo Google nem por nenhuma outra big tech.
Regra de ouro: nenhum número sai sem fonte medida. Não uso estimativa. Contagem pequena (menos de 10 eventos) sai com a ressalva de margem alta. A inspeção completa e a nota saem uma vez por mês, com a data à vista. Como a Cloudflare no plano Free guarda 31 dias de histórico (e consulta no máximo 30 por vez), a coleta roda semanalmente e é acumulada, e a nota mensal sai sobre o acumulado. No meu site, essa coleta semanal roda sem falha desde 08/09/2026. A citação por IA é mensal.
Só a nota do nosso site é pública. Ela vai ficar no KG Map FCF, de Felipe C. Ferreira, que está em construção, com os pontos a melhorar, a versão da régua e a data, e com acesso pelo ícone do rodapé e por links internos. A nota de cliente é privada e só sai com autorização dele.
Para o cliente, a entrega planejada é uma página online interativa na minha plataforma, com login: nós, entidades e @id do schema, independente da tecnologia do site dele, noindex e isolada por cliente, dentro da LGPD. É item de roteiro, ainda sem prazo.
C1 · CDN e Firewall
Peso 15. Camada trava.
1. O que inspecionamos
Se os robôs de busca e de IA recebem a página de verdade. Olho a CDN (rede de entrega de conteúdo), o firewall, a proteção anti-bot do servidor de origem, o DNS e o certificado, e as respostas para os arquivos de descoberta: robots.txt, llms.txt, sitemaps e o bundle OKF.
A camada vale para qualquer fornecedor. No meu caso, a Cloudflare fica na frente e a origem é a Hostinger, com servidor LiteSpeed. E o meu caso mostra uma coisa importante: o bloqueio do INS-01 acontece na origem, não na CDN. Ter CDN não resolve sozinho se a origem barra os robôs. A Hostinger oferece CDN própria em alguns planos, mas ela não está ativa no meu site e não roda junto com a Cloudflare.
2. Por que importa para o negócio
Conteúdo que o robô não recebe não entra no índice, não entra no treino e não é citado. Todo o investimento em texto, schema e links depende desta camada.
Quanto eu já paguei em conteúdo que o GPTBot nunca conseguiu ler?
Essa é a pergunta de caixa do C1. E por isso ele trava a nota.
3. Como medimos
- Fonte: logs da CDN, só bots verificados (identificados por IP e assinatura, não pelo texto do user-agent), por URL e por robô. Equivalente: logs do servidor com DNS reverso. Os comandos abaixo usam a Cloudflare porque é o meu caso.
- Fonte do DNS e TLS: verificação pública do certificado e dos redirecionamentos.
- Métrica principal: % das requisições de bots de IA verificados com 429 (ou 403), separando erro gerado na borda de erro gerado na origem.
- Janela: 28 dias fechados na rotina; mínimo de 7 dias para avaliar uma correção.
Passo a passo da inspeção
| Passo | O que conferir | Como (ferramenta ou comando) | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Configuração de bots na CDN | Painel ou API da Cloudflare: Bot Fight Mode, Block AI bots, AI Crawl Control, regras de WAF e rate limiting | Nenhuma regra barrando bot verificado | Print ou JSON da configuração, com data |
| 2 | 429 e 403 por robô verificado | Cloudflare GraphQL httpRequestsAdaptiveGroups, filtro verifiedBotCategory não vazio e userAgent_like por robô |
≤1% Aprovado; ≤10% Parcial; >10% Pendente | Totais por robô (req., 429, %) e o JSON bruto |
| 3 | Quem gera o erro | Mesma consulta, dimensões edgeResponseStatus × originResponseStatus |
Erro de origem e de borda separados | Tabela com as duas colunas |
| 4 | Arquivos de descoberta | Mesma consulta, por clientRequestPath (/, /robots.txt, /llms.txt, sitemaps, /okf/*) |
0 não-2xx Aprovado; ≤5% Parcial; >5% Pendente | Tabela por caminho e por robô |
| 5 | Cache e data center | Dimensões cacheStatus e coloCode; ler a configuração de Tiered Cache |
Erro nunca servido do cache | HIT por data center; nº de erros em HIT (deve ser 0) |
| 6 | Bots falsos na origem | Mesma base, user-agents de IA não verificados que chegam à origem | ≤10% Aprovado; ≤50% Parcial; >50% Pendente | % e amostra de URLs pedidas |
| 7 | 5xx na borda | Cloudflare httpRequests1dGroups |
≤0,1% Aprovado; ≤1% Parcial; >1% Pendente | % de 5xx no período |
| 8 | DNS e TLS | openssl s_client -servername <host> -connect <host>:443 para a validade do certificado; curl -sI em http://, http://www. e https://www. |
Certificado válido por mais de 14 dias; as três variantes chegam à versão canônica HTTPS em 1 salto; sem conteúdo misto | Data de expiração, emissor, cadeia de redirecionamento |
| 9 | Controle | Mesma consulta na janela imediatamente anterior | Comparação no mesmo tamanho de janela | Tabela antes e depois |
Exemplo de consulta (Cloudflare GraphQL, só leitura; ajuste zona, datas e robô):
query {
  viewer {
    zones(filter: { zoneTag: "<ZONA>" }) {
      httpRequestsAdaptiveGroups(
        limit: 1000
        filter: {
          datetime_geq: "2026-10-06T21:21:00Z"
          datetime_lt: "2026-10-13T12:20:00Z"
          verifiedBotCategory_neq: ""
          userAgent_like: "%GPTBot%"
        }
      ) {
        count
        dimensions {
          clientRequestPath
          edgeResponseStatus
          originResponseStatus
          cacheStatus
          coloCode
        }
      }
    }
  }
}
Limitação do plano Free da Cloudflare: desde 01/07/2026, agentes que assinam as próprias requisições (Web Bot Auth), como os do ChatGPT, entram na mesma contagem dos bots verificados. Separar uma categoria da outra exige o plano Enterprise com Bot Management. No meu plano, eu não meço agentes assinados nem agentes com navegador à parte, e não prometo essa medição a cliente com o mesmo plano.
Nota complementar: no plano Free, a Cloudflare amostra esses dados. Eu confiro o total de 429 contra a base diária sem amostragem (httpRequests1dGroups) e declaro a amostragem no registro.
Teste com user-agent declarado (útil para reproduzir um sintoma, nunca para dar nota), espaçado em uma requisição a cada 3 s ou mais:
curl -s -A "<user-agent do robô>" -D cabecalhos.txt -o corpo.html \
  -w '%{http_code}\t%{size_download}\t%{time_starttransfer}\n' \
  https://exemplo.com.br/robots.txt
Um teste com user-agent declarado não é o robô verdadeiro. Ele mostra o que um leitor identificado como aquele robô recebeu, naquela data, daquela origem. Eu não converto esse teste em “aprovado” de log real.
Por que o robots.txt pesa tanto? Pelo RFC 9309, se o robots.txt responde erro de servidor (5xx), o crawler deve assumir bloqueio total. O Google trata o 429 no robots.txt como erro de servidor, conforme a documentação dele. Ponto de observação: a política de cada crawler de IA para o 429 no robots.txt ainda está sendo conferida, um por um. Até lá, vale só o que o RFC 9309 e o Google documentam, e esta parte será atualizada na próxima inspeção mensal.
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| Crawlers de IA verificados sem 429 ou 403 | ≤1% | ≤10% | >10% |
| Arquivos de descoberta sem erro para bots verificados | 0 | ≤5% | >5% |
| Bots falsos filtrados antes da origem | ≤10% chega à origem | ≤50% | >50% |
| 5xx na borda | ≤0,1% | ≤1% | >1% |
| DNS e TLS: certificado válido, HTTP e com/sem www para a versão canônica HTTPS em 1 salto, sem conteúdo misto | Tudo conforme | Certificado válido, mas redirecionamento em mais de 1 salto ou conteúdo misto | Certificado inválido ou a vencer em menos de 14 dias, ou variante sem redirecionamento |
5. Como está no nosso site
Status: Pendente. INS-01 aberto. A trava de 70 na nota global continua.
DNS e TLS (conferido em 16/10/2026): certificado válido até 21/12/2026, emitido por Google Trust Services; https://www. redireciona com 301 para https://felipecferreira.com.br/ em 1 salto. O redirecionamento de HTTP para HTTPS fica “a medir” até um teste de outra origem. Ponto de observação: o teste de HTTP para HTTPS será refeito de outra origem, e o resultado entra aqui com a data.
O caso, com números e datas:
- Linha de base (30 dias até 06/10/2026, Cloudflare, bots verificados): o GPTBot recebeu 429 em 767 de 901 requisições (85,1%) e o meta-externalagent em 4.221 de 6.462 (65,3%). Googlebot, Bingbot, ClaudeBot, OAI-SearchBot e ChatGPT-User: zero 429.
- Arquivos de descoberta (GPTBot, mesma janela):
/llms.txtcom 5 de 5 em 429;/sitemap_index.xmlcom 29 de 31; home com 36 de 51. - Quem gera: 100% dos 429 vieram da origem (servidor LiteSpeed da Hostinger), zero da Cloudflare. A CDN não bloqueava; a origem, sim. O suporte da Hostinger confirmou nos logs, atribuiu a limites automáticos do servidor e informou que não abre exceção por user-agent, caminho ou faixa de IP.
- Leitura real (12/09 a 11/10/2026): o Googlebot verificado leu 126 de 145 URLs do sitemap; o GPTBot verificado, 30.
O que já foi feito. Em 06/10/2026, entrou uma regra de cache na Cloudflare que guarda na borda, por 4 h, só as respostas 200 da home, robots.txt, llms.txt, sitemaps e OKF. Erro nunca entra no cache.
Remedição de 7 dias (13/10/2026): o GPTBot recebeu 429 em 568 de 630 requisições (90,2%), igual aos 7 dias anteriores à regra (90,3%). A regra funciona para o tráfego geral e zero erro foi servido do cache. Mas 628 das 630 requisições do GPTBot passaram por um único data center (Atlanta), em rajada de madrugada, onde a cópia em cache quase nunca estava válida. O resultado de 48 h (50%) era ruído de amostra pequena: 6 requisições.
Achado novo da mesma remedição: o Amazonbot verificado recebeu 403 da origem em 14 de 35 requisições.
Próximos passos, em ordem de custo e risco: cache em camadas da Cloudflare (Smart Tiered Cache) e TTL maior nos arquivos de descoberta, com remedição de 7 dias; depois, cache dos posts; e, como solução estrutural, uma hospedagem sem limitador automático por crawler. Ponto de observação: os dois primeiros passos entraram na Cloudflare em 14/10/2026, e este dado será atualizado na remedição programada de 21/10/2026.
6. Evidência autoral
O caminho de diagnóstico que eu uso aqui é replicável: bots verificados × erro de borda × erro de origem × status de cache × data center, com janela de controle e escopo separado. Cinco cortes que transformam “acho que a hospedagem bloqueia IA” em evidência.
As consultas e os registros do caso INS-01 ficam no nosso acervo interno de dados. A regra de cache foi desenhada para nunca guardar erro (TTL por status, sem armazenamento para 4xx e 5xx).
7. Conteúdos que aplicam esta camada
- Bots ou Agentes de IA?, para separar robô de agente antes de olhar os logs.
- VPS para Automação com IA, que entra quando a decisão é trocar de hospedagem.
- O estudo de caso completo do INS-01 ainda não está publicado.
C2 · Servidor e Desempenho
Peso 10.
1. O que inspecionamos
Tempo de resposta da origem, Core Web Vitals, cache na borda, compressão, protocolo e cache de arquivos estáticos.
2. Por que importa para o negócio
Robô e cliente desistem de página lenta. Para o robô, servidor lento é orçamento de rastreio gasto com espera. Para o cliente, é anúncio pago que cai numa tela branca.
Cada segundo de espera é custo de aquisição que eu pago e não vejo na planilha.
3. Como medimos
- Fonte: PageSpeed Insights API (dados de campo do CrUX quando houver; senão, laboratório, declarado) e Cloudflare (
originResponseDuration,cacheStatus). - Métrica: TTFB (tempo até o primeiro byte) p75; LCP, INP e CLS p75 por template; % de HIT na borda.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Amostra de templates | Escolher home, hub de pilar, listagem, post e documento | 1 URL por template, no mínimo | Lista de URLs com data |
| 2 | TTFB da origem | PSI API (runPagespeed, mobile) com chave própria + Cloudflare originResponseDuration |
≤800 ms Aprovado; ≤1.800 ms Parcial; >1.800 ms Pendente | JSON da PSI e p75 da Cloudflare |
| 3 | Core Web Vitals | PSI API (campo CrUX; senão laboratório) | “Bom” nos 3 Aprovado; 1 ou 2 bons Parcial; nenhum Pendente | Valores de LCP, INP e CLS e a origem do dado (campo ou lab) |
| 4 | Cache na borda | Cloudflare GraphQL por cacheStatus |
≥60% HIT Aprovado; ≥30% Parcial; <30% Pendente | % HIT de HTML e de estáticos, separados |
| 5 | Compressão e protocolo | curl -s -H 'Accept-Encoding: br' -w '%{http_version} %{size_download} %{time_starttransfer}' -o /dev/null <URL> |
br ou gzip ativo; HTTP/2 ou superior | Saída do comando por URL |
| 6 | Cache de estáticos | curl -sI <URL do CSS ou imagem> |
cache-control com max-age longo |
Cabeçalhos copiados |
Os limites de TTFB e de Core Web Vitals seguem as faixas publicadas pelo Google em web.dev (ver Referências).
Nota complementar: site com pouco tráfego pode não ter dado de campo no CrUX. Aí uso laboratório e escrevo isso no registro. Laboratório não é experiência real de usuário.
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| TTFB da origem (p75) | ≤800 ms | ≤1.800 ms | >1.800 ms |
| Core Web Vitals (p75 por template) | Bom nos 3 | 1 ou 2 bons | Nenhum |
| Cache na borda | ≥60% HIT | ≥30% | <30% |
5. Como está no nosso site
Status: a medir.
O que já sei (inspeção de 06/10/2026, a partir de um servidor externo): br e gzip ativos, HTTP/2, estáticos com max-age de 7 dias e HIT na Cloudflare. O HTML não é cacheado pela Cloudflare (DYNAMIC). TTFB em amostra única, com hit no cache do LiteSpeed, entre 0,193 s e 0,218 s em quatro URLs.
O Lighthouse não rodou: a PSI sem chave devolveu 429 de cota e o Lighthouse local levou 403 do próprio INS-01. Não há nota de Core Web Vitals nesta rodada.
6. Evidência autoral
A higienização do WordPress (pastas, banco e filas) e o tema que roda o site, o ASC Theme, são projetos meus, proprietários, não comercializados e sem código público. A inspeção de 06/10 apontou o que ainda pesa nele: main.css com 110 KB em todas as páginas, mais 17 a 49 KB de CSS inline por página, e imagens majoritariamente em PNG.
7. Conteúdos que aplicam esta camada
C3 · HTML e Acessibilidade
Peso 10.
1. O que inspecionamos
Se o HTML que chega ao robô está íntegro: um H1 por página, hierarquia de headings, blocos fechados, HTML sem lixo de editor, lang, texto alternativo (alt) nas imagens, landmarks e status HTTP das URLs do sitemap. E se o conteúdo principal já vem no HTML que o servidor entrega, sem depender de JavaScript.
2. Por que importa para o negócio
HTML quebrado faz o robô e o leitor verem a página errada. Uma seção duplicada ou um título fora de ordem confundem quem resume a página, seja um buscador, seja um assistente de IA.
E tem um ponto que pouca gente olha: a maioria dos robôs de IA não executa JavaScript. O próprio Google lembra que nem todo robô consegue rodar JavaScript; o Googlebot renderiza as páginas com status 200 numa fila, que pode levar de segundos a mais tempo. Uma medição da Vercel publicada em dezembro de 2024 não encontrou renderização de JavaScript nos robôs da OpenAI, da Anthropic, da Meta, da ByteDance e da Perplexity (Gemini, pela infraestrutura do Googlebot, e Applebot renderizam). Se o texto da página só aparece depois que o navegador roda um script, para esses robôs a página está vazia.
3. Como medimos
- Fonte: rastreamento (crawl) do HTML público a partir dos sitemaps, mais Lighthouse Acessibilidade pela PSI API.
- Métrica: % de URLs conformes por critério.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Lista de URLs | Ler sitemap_index.xml e cada sub-sitemap ao vivo |
Todas as URLs do sitemap | Lista com data e total |
| 2 | Status HTTP | GET espaçado em cada URL (1,5 s ou mais entre requisições); pedir também uma URL inexistente (deve dar 404, não 200) e seguir os 301 até o fim (não pode terminar em 404) | 100% com 200 sem redirecionamento Aprovado; ≥95% Parcial; <95% Pendente | Tabela URL, status, destino |
| 3 | H1 e hierarquia | Parser sobre o HTML: contar <h1>, verificar saltos de nível |
≥95% conformes Aprovado; ≥80% Parcial; <80% Pendente | Lista de URLs não conformes |
| 4 | Blocos e seções duplicadas | Parser: cada H2 aparece uma vez; blocos abertos e fechados | Nenhuma duplicata | URL e trecho duplicado |
| 5 | alt e acessibilidade |
Parser (% de <img> de conteúdo com alt) + Lighthouse Acessibilidade |
≥90 Aprovado; ≥70 Parcial; <70 Pendente | % de alt e score por template |
| 6 | IDs duplicados | Parser: atributos id repetidos na mesma página |
Zero | URL e ID |
| 7 | Conteúdo sem JavaScript | Baixar o HTML bruto (curl) e o HTML renderizado (navegador sem interface); comparar o texto principal |
Texto principal presente no HTML bruto em ≥95% das URLs Aprovado; ≥80% Parcial; <80% Pendente | URL, % do texto presente no HTML bruto |
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| Um H1 por página e hierarquia correta | ≥95% | ≥80% | <80% |
| HTML semântico e acessibilidade | ≥90 | ≥70 | <70 |
| Status HTTP das URLs do sitemap: 200 sem redirecionamento, sem soft 404 (página inexistente respondendo 200) e sem 301 que termina em 404 | 100% conformes | ≥95% | <95% |
| Conteúdo principal no HTML do servidor, sem depender de JavaScript | ≥95% | ≥80% | <80% |
5. Como está no nosso site
Status: a medir. O crawl de 12/10/2026 cobriu 145 URLs, mas os headings ainda não foram pontuados. O critério de conteúdo sem JavaScript nunca foi medido.
Conferido em 16/10/2026: uma URL inexistente do nosso site responde 404, como deve. Remedido em 17/10/2026: a URL antiga /blog/como-criar-imagens-com-inteligencia-artificial/ faz 301 para um endereço que responde 404. Foi esse caso, ligado ao tema do post 635, que motivou a ampliação do critério.
Sem JavaScript na C3, versão para máquina na C7. O nosso bundle OKF oferece às máquinas uma versão em texto limpo de cada página (ver C7). Isso não substitui o critério desta camada: os buscadores e a maioria dos robôs de IA leem a página HTML, e não há evidência pública de que todos usem llms.txt ou versões em Markdown. Por isso são dois critérios.
Caso real: em 12/10/2026, a página 7805 “Tráfego e Dados” exibiu uma seção duplicada por causa de dois fechamentos de bloco ausentes. Corrigi no mesmo dia, e cada H2 voltou a aparecer uma vez.
Pendências medidas na inspeção de 06/10/2026: 261 anexos sem alt no banco e 128 páginas com <img alt=""> fora do logo; 1 post com id="h-" duplicado.
6. Evidência autoral
O ASC Theme gera a estrutura das páginas (H1 único pelo título, painel de perguntas frequentes, blocos do Resumo). É projeto proprietário, não comercializado e sem código público.
7. Conteúdos que aplicam esta camada
- O que é o WordPress, para quem precisa entender onde o HTML é gerado.
C4 · Metadados
Peso 10.
1. O que inspecionamos
Title, meta description, canonical, og:title e og:description, a coerência entre eles, e se o que o sitemap promete bate com o que a página declara sobre indexação.
2. Por que importa para o negócio
O title e a description são a vitrine no resultado de busca e o primeiro resumo que a máquina lê. Quando o og:title diz uma coisa e o title diz outra, o site manda dois recados diferentes sobre a mesma página.
3. Como medimos
- Fonte: crawl do HTML público; no nosso site, leitura dos campos do Yoast pelo servidor (WP-CLI, só leitura).
- Métrica: % de URLs conformes.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Title e description presentes e únicos | Parser no crawl: <title> e meta name="description"; agrupar duplicatas |
≥95% Aprovado; ≥80% Parcial; <80% Pendente | Lista de ausentes e de duplicados |
| 2 | Coerência do og | Parser: comparar og:title com <title> e og:description com a description |
100% coerentes Aprovado; ≥90% Parcial; <90% Pendente | Pares divergentes, URL por URL |
| 3 | Canonical | Parser: link rel="canonical" auto-referente, sem parâmetro |
100% Aprovado; ≥95% Parcial; <95% Pendente | URLs com canonical inválido |
| 4 | Campos de origem (site próprio) | wp post meta get <ID> _yoast_wpseo_title e _yoast_wpseo_metadesc |
Preenchidos à mão, sem template automático | Saída do comando por ID |
| 5 | Indexabilidade coerente | Parser no crawl: meta name="robots" e cabeçalho X-Robots-Tag de cada URL do sitemap; comparar a URL com o canonical declarado |
Nenhuma URL do sitemap com noindex e todas auto-canônicas Aprovado; ≤5% fora Parcial; >5% Pendente | URLs com noindex ou canonical apontando para outra URL |
| 6 | Datas honestas | Listar dateModified de todos os posts (WP-CLI ou JSON-LD) e agrupar por data; comparar cada grupo grande com o histórico de revisões para separar edição real de atualização técnica em massa |
≥95% dos posts com data coerente Aprovado; ≥80% Parcial; <80% Pendente (limites provisórios, em validação) | Grupos de posts com a mesma data e a origem da mudança |
Nota sobre WordPress com Yoast SEO. No meu site, a gestão do sitemap é feita pelo Yoast SEO, que é a escolha de stack do site, e não uma regra geral. Quando eu marco uma página como noindex, o Yoast tira essa URL do sitemap automaticamente na atualização seguinte. Segundo a documentação oficial do Yoast, o mesmo vale para a página cujo canonical aponta para outra URL. Por isso, num site em que tudo passa pelo Yoast, este critério tende a ser aprovado, e a inspeção se concentra no que o plugin não enxerga: noindex enviado no cabeçalho X-Robots-Tag pelo servidor ou pela CDN, noindex colocado pelo tema ou por outro plugin, URL que segue no sitemap com o canonical apontando para outra página, um segundo sitemap ativo (como o nativo do WordPress) e sitemap desatualizado em cache. Se o site usa outro plugin de SEO, WordPress sem o Yoast ou outra stack ou tecnologia, eu verifico como aquela ferramenta faz a gestão do sitemap e da indexabilidade, e confiro o critério URL por URL, sem presumir essa exclusão automática.
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| Title e meta description presentes e únicos | ≥95% | ≥80% | <80% |
| og:title e og:description coerentes com o title | 100% | ≥90% | <90% |
| Canonical correto | 100% | ≥95% | <95% |
| Indexabilidade coerente: nenhuma URL do sitemap com noindex (meta robots ou X-Robots-Tag) e o sitemap lista só URLs canônicas | 100% | ≥95% | <95% |
Datas honestas: o “Atualizado em” e o dateModified mudam só com edição real de conteúdo, nunca por atualização técnica em massa (limites provisórios, em validação) |
≥95% | ≥80% | <80% |
O status 200 das URLs do sitemap não entra aqui: ele já é medido na C3. A C4 olha só noindex e coerência de canonical, para não contar o mesmo problema duas vezes.
Critério oficial desde 16/10/2026 (decisão 15): datas honestas. Atualização técnica em massa não deve mudar o “Atualizado em” nem o dateModified. Caso real (inspeção de 06/10/2026): uma edição programática em 27 e 28/07/2026 mudou o dateModified de 84 posts, inclusive notícias de 2024 que passaram a exibir “Atualizado em 28/07/2026”.
5. Como está no nosso site
Status: a medir.
Pendência conhecida, conferida de novo em 16/10/2026: na 7805 “Tráfego e Dados”, o title é “Tráfego e Dados: Investimento com Mensuração” e o og:title é “Tráfego e Dados: verba que sabe quando escalar”.
6. Evidência autoral
O padrão de metadados (title escrito à mão, description de 120 a 156 caracteres, sem travessão) é regra do meu método de produção de conteúdo, aplicado em cada revisão de post.
7. Conteúdos que aplicam esta camada
- JSON-LD como infraestrutura de dados para SEO, GEO e AEO, na parte de auditoria de metadados e dados estruturados.
C5 · Schema e Entidades
Peso 15.
1. O que inspecionamos
JSON-LD (dados estruturados) válido, @id estáveis, autor ligado à Person pelo @id, Organization e Person com sameAs limpo, campos obrigatórios por tipo, entidades duplicadas e ofertas (Service, Offer, Book) completas.
2. Por que importa para o negócio
É assim que a máquina entende quem é o autor, o que a empresa faz e o que ela vende. Sem isso, a IA pode até ler a página, mas não liga o conteúdo à pessoa nem à oferta.
Se um assistente de IA não sabe que o especialista do post é a mesma pessoa que vende a consultoria, quem ganha a recomendação?
3. Como medimos
- Fonte: extração dos blocos
application/ld+jsonde todas as URLs do sitemap, parser estrutural, validator.schema.org e Rich Results Test (manual, por amostra). - Métrica: % de URLs conformes por critério.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | JSON-LD presente e parseável | Extrair todos os blocos ld+json do crawl e fazer json.loads |
100% Aprovado; ≥90% Parcial; <90% Pendente | URLs sem bloco ou com erro de parse |
| 2 | Uma Person e uma Organization | Contar @id distintos de Person e Organization em todas as páginas; ler sameAs |
1 Person + 1 Organization e sameAs limpo Aprovado; ids ok e sameAs com falha Parcial; ids divergentes Pendente |
Lista de @id e de sameAs |
| 3 | Autor ligado por @id |
Em todo Article e TechArticle, conferir author.@id = @id da Person |
100% Aprovado; ≥80% Parcial; <80% Pendente | Contagem e exceções |
| 4 | BreadcrumbList válido | Posições sequenciais, name e item |
100% Aprovado; ≥90% Parcial; <90% Pendente | Exceções |
| 5 | Entidades duplicadas | Mesmo objeto (ex.: vídeo do YouTube) com mais de um @id |
0 Aprovado; ≤2 Parcial; >2 Pendente | Objeto e @id envolvidos |
| 6 | Campos obrigatórios por tipo | Article: headline, datePublished, author, image |
100% Aprovado; ≥90% Parcial; <90% Pendente | URLs sem campo |
| 7 | Ofertas completas | Service, Offer e Book com campos obrigatórios; preço idêntico ao texto visível | Todos Aprovado; falta 1 tipo Parcial; mais Pendente | Tipo e campo faltante |
| 8 | Validação externa | validator.schema.org e Rich Results Test em 1 URL por template | Sem erro | Print com data |
Exemplo rápido para conferir o autor de uma página (só leitura):
curl -s https://exemplo.com.br/<url-do-post>/ \
  | python3 -c "import sys,re,json; [print(n.get('@type'), n.get('author')) for b in re.findall(r'application/ld\+json[^>]*>(.*?)</script>', sys.stdin.read(), re.S) for n in json.loads(b).get('@graph', [])]"
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| JSON-LD presente e parseável | 100% | ≥90% | <90% |
Person e Organization com @id único e sameAs limpo |
Ambos ok | ids ok, sameAs com falha |
ids divergentes |
Autor ligado por @id |
100% | ≥80% | <80% |
| BreadcrumbList válido | 100% | ≥90% | <90% |
| Entidades duplicadas | 0 | ≤2 | >2 |
| Campos obrigatórios por tipo | 100% | ≥90% | <90% |
| Offers e Service completos | Todos | Falta 1 tipo | Mais |
5. Como está no nosso site
Status: Parcial. Nota 64,3 na linha de base de 12/10/2026 (145 URLs do sitemap, pelo servidor, só leitura).
- Aprovado, autor por
@id(KG-02): 114 de 114 artigos (111 Article e 3 TechArticle). Conferido por amostra ao vivo em 16/10/2026 (Protocolo L0 : L7 e um post da Biblioteca). - Aprovado, BreadcrumbList: 144 de 144 estruturalmente válidos.
- Parcial, JSON-LD presente: 144 de 145. A exceção é o
/mapa/, sem nenhum bloco. - Parcial, identidade: uma Person e uma Organization em todas as páginas, mas a Organization sai sem
sameAs(KG-06) e a Person com perfis antigos ou com parâmetro (KG-08). Conferido em 16/10/2026. - Parcial, duplicatas: 2 de 7 vídeos com mais de um
@id. - Parcial, campos obrigatórios: 110 de 114. Quatro documentos ou posts sem
image, entre eles o próprio Protocolo L0 : L7. - Parcial, ofertas: 8 Service com provider ligado à Organization; o Book do livro tem Offer, mas sem preço nem moeda (conferido em 16/10/2026).
Limitação declarada: na linha de base, a validação foi estrutural. Rich Results Test e validator.schema.org ainda não rodaram.
6. Evidência autoral
O schema do site sai de uma fonte única da verdade, no ASC Theme e no plugin de núcleo do site, os dois proprietários, não comercializados e sem código público. A correção do KG-02 foi feita ali. O POP de implementação e homologação de JSON-LD é o procedimento que eu sigo antes de publicar qualquer bloco novo.
7. Conteúdos que aplicam esta camada
- JSON-LD como infraestrutura de dados para SEO, GEO e AEO.
- POP: Implementação e homologação de JSON-LD.
- O que É um Knowledge Graph e Como Ele Funciona na Prática?
C6 · Grafo e Links Internos
Peso 15.
1. O que inspecionamos
Como as páginas se ligam: posts órfãos (sem link de corpo vindo de outro post), ligação dos posts com a página do pilar, links internos quebrados, profundidade de clique a partir da home, URLs com parâmetro no grafo e quantas páginas os robôs verificados de fato leram.
2. Por que importa para o negócio
Página que ninguém linka é página que o robô demora a achar, ou nunca acha. E o link interno é o que diz para a máquina “este post faz parte deste assunto, e este assunto é o que eu vendo”.
Grafo interno bem ligado é o que transforma uma pilha de posts em autoridade num tema.
3. Como medimos
- Fonte: crawl de todas as URLs do sitemap (no nosso site, executado no próprio servidor), grafo de links do corpo do post e logs da CDN para a leitura por robôs.
- Métrica: contagens e percentuais por critério.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Grafo de links | Parser no HTML de cada URL: links do corpo (área de conteúdo) e da página inteira, separados | Todas as URLs do sitemap | Arquivo do grafo com data |
| 2 | Órfãos | Posts sem link de corpo vindo de outro post | 0 Aprovado; ≤5 Parcial; >5 Pendente | Lista de órfãos com ID e título |
| 3 | Cluster ligado ao pilar | % de posts com link de corpo para a página do seu pilar | ≥90% Aprovado; ≥60% Parcial; <60% Pendente | Lista de posts sem o link |
| 4 | Links quebrados | Links de corpo para 404 (e cadeias de 301) | 0 Aprovado; ≤5 Parcial; >5 Pendente | Origem, destino e status |
| 5 | Profundidade | Busca em largura a partir da home, só URLs do sitemap | ≥90% a até 3 cliques Aprovado; ≥70% Parcial; <70% Pendente | Distribuição por nível e não alcançadas |
| 6 | Parâmetros no grafo | Links internos e sameAs com query string |
0 Aprovado; ≤3 Parcial; >3 Pendente | Lista |
| 7 | Nós lidos por robôs | URLs do sitemap com pelo menos um 2xx de robô verificado (pior entre GPTBot e Googlebot) | ≥90% Aprovado; ≥60% Parcial; <60% Pendente | Contagem por robô, com janela |
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| Posts órfãos | 0 | ≤5 | >5 |
| Cluster ligado ao hub do pilar | ≥90% | ≥60% | <60% |
| Links internos quebrados e cadeias de 301 | 0 | ≤5 | >5 |
| Profundidade de clique (≤3) | ≥90% | ≥70% | <70% |
| URLs sem parâmetro no grafo | 0 | ≤3 | >3 |
| Nós lidos por bots verificados | ≥90% | ≥60% | <60% |
5. Como está no nosso site
Status: Pendente. Nota 25,0 na linha de base de 12/10/2026.
- Pendente, órfãos: 53 de 111 posts.
- Pendente, ligação com o pilar: 11 de 111 posts (9,9%) linkavam a página do seu pilar.
- Pendente, leitura por robôs: GPTBot leu 30 de 145 URLs (20,7%); Googlebot, 126 (86,9%). Dos 53 órfãos, o GPTBot leu só 8.
- Parcial, links quebrados: 3 PDFs em 404 e 7 links de corpo passando por 301 antigos.
- Parcial, profundidade: 108 de 145 URLs (74,5%) a até 3 cliques; 29 não alcançadas pela home.
- Parcial, parâmetros: zero no corpo, mas o
sameAsda Person ainda leva?sub_confirmation=1.
Desde 13/10, estou revisando posts com link para o pilar e links de entrada para os órfãos. Ponto de observação: os números desta camada são da linha de base de 12/10/2026. A remedição com o mesmo script entra na próxima inspeção mensal, com a data, e atualiza esta seção e a Transparência.
6. Evidência autoral
O KG Map FCF, de Felipe C. Ferreira, é o plugin que lê os dados internos do nosso site (posts, termos, schema e @id) e projeta o grafo para humanos. É projeto proprietário, não comercializado e sem código público. Ele não é crawler externo nem motor de nota: a nota vem da régua deste documento.
7. Conteúdos que aplicam esta camada
C7 · Acesso por Agentes de IA
Peso 10.
1. O que inspecionamos
Se o site libera e entrega os arquivos que agentes e crawlers de IA procuram: robots.txt com permissão explícita, llms.txt presente e acessível, uma versão de cada página para máquina (no nosso caso, o bundle OKF, Open Knowledge Format, em Markdown) e se os robôs de IA estão, de fato, rastreando.
2. Por que importa para o negócio
Agente de IA não navega como gente. Ele procura a porta de entrada: robots.txt, llms.txt, sitemap e versões legíveis por máquina. Se a porta existe mas responde erro, o efeito é igual a não ter porta.
E aqui tem uma diferença que vale dinheiro: liberar no robots.txt não garante acesso. O meu próprio site libera todos os principais robôs e, mesmo assim, o GPTBot levou 429 no llms.txt.
3. Como medimos
- Fonte:
robots.txt,llms.txte versão para máquina públicos, e logs da CDN ou do servidor (bots verificados). Sem log, o público confirma só que ollms.txtexiste, e o critério fica no máximo Parcial. - Métrica: permissão declarada e resposta 200 real para bots verificados.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | robots.txt | curl -s https://exemplo.com.br/robots.txt; ler grupos por user-agent |
Allow para GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot e demais principais | Cópia do arquivo com data |
| 2 | Estrutura do robots.txt | Conferir se regras soltas caem no grupo errado e se os grupos de bots herdam o que precisam | Sem regra órfã | Linhas problemáticas |
| 3 | llms.txt presente | curl -s -o /dev/null -w '%{http_code}' https://exemplo.com.br/llms.txt |
200, conteúdo coerente com o site | Status e cópia |
| 4 | llms.txt para bots verificados | Logs da CDN, caminho /llms.txt, bots verificados |
100% em 200 Aprovado; ≥80% Parcial; <80% Pendente | Tabela por robô |
| 5 | Versão para máquina | Amostra de páginas: existe versão em texto limpo? O cabeçalho aponta o canonical para o HTML? A rota está declarada no llms.txt? |
Todas as condições em ≥95% das páginas da amostra Aprovado; versão existe, mas falta canonical ou rota Parcial; sem versão Pendente | URL do HTML, URL da versão, cabeçalho copiado |
| 6 | Robôs rastreando | Logs da CDN: requisições 2xx por semana de GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot | Todos >0 Aprovado; alguns Parcial; nenhum Pendente | Contagem por robô |
4. Critérios
| Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|
| robots.txt permite crawlers de IA | Todos os principais | Maioria | Bloqueio |
| llms.txt presente e acessível para bots verificados | 100% | ≥80% | <80% |
| Bots de IA efetivamente rastreando | Todos >0 | Alguns | Nenhum |
| Versão para máquina com canonical para o HTML e rota no llms.txt | Completa | Incompleta | Ausente |
O acesso real dos bots verificados a /okf/* já é medido na C1 (arquivos de descoberta), por isso não vira critério separado aqui.
5. Como está no nosso site
- robots.txt: Aprovado. Conferido em 16/10/2026: Allow explícito para robôs de treino (GPTBot, Google-Extended, ClaudeBot e outros), de busca (OAI-SearchBot, Googlebot, bingbot, PerplexityBot e outros) e de acesso a pedido do usuário (ChatGPT-User, Claude-User, Perplexity-User e outros).
- llms.txt: Pendente. Responde 200 para um leitor comum (16/10/2026), mas o GPTBot verificado levou 429 em 5 de 5 requisições nos 30 dias até 06/10 e em 8 de 9 na remedição de 13/10. Depende do INS-01.
- Versão para máquina: a medir na amostra completa. Conferido ao vivo em 16/10/2026: o
llms.txtaponta as representações OKF em/okf/*.mde diz que o HTML permanece a fonte canônica; o arquivo OKF do pilar Busca e Autoridade traz no cabeçalhoresourceesources.canonical-htmlapontando para a página HTML; orobots.txtcita ollms.txte o índice OKF em comentário e temAllow: /okf/. Por isso não há conteúdo duplicado: a máquina sabe qual é a origem. - Acesso ao OKF (lido na C1): o GPTBot levou 429 em 42 de 42 requisições a
/okf/*na remedição de 13/10. - Robôs rastreando (30 dias até 06/10): ClaudeBot 1.350 requisições, OAI-SearchBot 482, ChatGPT-User 260; GPTBot só 65 com 2xx. Ponto de observação: o status deste critério sai no primeiro ciclo mensal completo de medição.
Pendência de estrutura (inspeção de 06/10): o Allow: /okf/ do bloco OKF fica solto e acaba anexado ao grupo *.
6. Evidência autoral
O OKF Manager (OKF Bundle Manager) gera o bundle /okf/, com o canonical de cada arquivo, e o llms.txt do site. A política de crawlers de IA do robots.txt sai do ASC Theme. Os dois são projetos proprietários, não comercializados e sem código público.
7. Conteúdos que aplicam esta camada
- OKF Bundle Manager: Machine Discoverability no WordPress.
- O que são Agentes de IA?
- Bots ou Agentes de IA?
C8 · Indexação e Citação por IA
Peso 15: indexação 10 e citação por IA 5.
1. O que inspecionamos
Duas coisas diferentes, medidas separadas:
- Indexação: quantas URLs do sitemap estão de fato no índice do Google.
- Citação por IA: se o site ou a marca aparecem nas respostas de assistentes de IA para um conjunto fixo de perguntas.
2. Por que importa para o negócio
É aqui que o trabalho das outras sete camadas vira visita e contato. Mas eu separo as duas medidas de propósito: nota técnica alta não garante citação. Quem promete citação a partir de checklist técnico está vendendo o que não mede.
Quando o meu cliente pergunta ao ChatGPT quem resolve o problema dele, o meu nome aparece?
3. Como medimos
Indexação (peso 10)
- Fonte: Search Console, API de Inspeção de URL (em rodízio, pela cota diária) e Search Analytics com dados finais.
- Métrica: % de URLs “Enviada e indexada”.
- Sinal complementar, sem nota: cliques, impressões e posição em 28 dias. Fica fora da nota até termos 3 meses de dado limpo.
Citação por IA (peso 5)
- Fonte: teste manual datado, com prompts fixos, em ChatGPT, Gemini, Perplexity, AI Overviews e Copilot. No meu site, uso a lista de exemplo publicada logo abaixo. Para cliente, na contratação, os prompts são escritos de forma personalizada.
- Métrica: % de respostas em que a marca ou o site são citados, sobre o total de respostas da rodada (prompt × assistente × dia). Com a lista de exemplo, são 6 prompts em 5 assistentes e em 2 dias: 60 respostas por rodada.
- Sinal complementar, sem nota: sessões vindas de assistentes de IA no GA4 (canal de assistentes de IA e referrers como chatgpt.com, copilot.com e perplexity.ai). O GA4 fica fora da nota porque mede a visita humana, que é consequência; a nota mede se a máquina acessa, entende, indexa e cita.
Passo a passo da inspeção
| Passo | O que conferir | Como | Limite | Evidência a registrar |
|---|---|---|---|---|
| 1 | Indexação por URL | API de Inspeção de URL do Search Console, em rodízio | ≥90% indexadas Aprovado; ≥60% Parcial; <60% Pendente | Resultado por URL com data |
| 2 | Sitemap no Search Console | Relatório de sitemaps | Sem erro nem aviso | Print com data |
| 3 | Desempenho orgânico (sem nota) | Search Analytics, 28 dias fechados, contra os 28 anteriores | Só acompanhamento | Cliques, impressões, posição |
| 4 | Conjunto de prompts | Lista fixa por intenção de busca: no meu site, a lista de exemplo desta página; para cliente, prompts personalizados na contratação | Mesma lista em todas as rodadas | Lista versionada, com data |
| 5 | Teste de citação | Rodar cada prompt em cada assistente, em 2 dias diferentes, sessão sem histórico | ≥50% das respostas com citação Aprovado; ≥20% Parcial; <20% ou sem teste Pendente | Resposta literal, fontes citadas, data, assistente |
| 6 | Visitas de IA (sem nota) | GA4, canal de assistentes de IA e referrers | Só acompanhamento | Sessões em 28 dias |
Nota complementar: o campo de URLs indexadas da API de sitemaps do Search Console é obsoleto. Para indexação, uso a Inspeção de URL.
Prompts de exemplo do teste de citação (lista 1, do meu site)
Estas são as perguntas que eu uso para medir a citação do meu próprio site. Elas cobrem o que eu de fato faço: SEO e GEO, autoridade, tecnologia aplicada, tráfego e dados e consultoria. Nenhuma cita o meu nome nem o domínio, para não induzir a resposta.
| # | Intenção | Prompt |
|---|---|---|
| 1 | Conceito (SEO e GEO) | O que é GEO (otimização para motores generativos) e o que muda em relação ao SEO para o site de uma empresa no Brasil? |
| 2 | Técnica (acesso de robôs) | Como saber se os robôs de IA, como o GPTBot, conseguem acessar o site da minha empresa, e o que pode estar bloqueando esse acesso? |
| 3 | Autoridade (schema e entidades) | Como usar JSON-LD e Schema.org para que o Google e os assistentes de IA entendam quem é a empresa, quem é o autor e quais serviços o site oferece? |
| 4 | Tecnologia aplicada (WordPress) | Como preparar um site em WordPress para ser lido por agentes de IA, com llms.txt e uma versão em texto limpo das páginas, sem perder o HTML como versão principal? |
| 5 | Tráfego e dados (mensuração) | Como medir no GA4 as visitas que chegam do ChatGPT, do Copilot e do Perplexity, e ligar essas visitas a contatos e vendas? |
| 6 | Contratação (consultoria) | Quem faz consultoria de SEO e GEO no Brasil para preparar o site de uma empresa para buscadores e assistentes de IA? |
Como cada rodada é feita e registrada. Cada prompt é rodado em cada um dos 5 assistentes (ChatGPT, Gemini, Perplexity, AI Overviews e Copilot), em 2 dias diferentes, sempre em sessão sem histórico (sem login ou em janela anônima). Para cada resposta, eu registro a data, o assistente, a resposta literal, as fontes citadas e o resultado: Citado, quando a resposta menciona Felipe C. Ferreira ou traz o felipecferreira.com.br entre as fontes, ou Não citado. A porcentagem da C8 é calculada sobre o total de respostas da rodada, e não sobre os prompts: cada combinação de prompt, assistente e dia conta como uma resposta. Assim, a nota mostra a diferença entre os assistentes, em vez de dar o prompt inteiro como citado porque um assistente citou uma vez. A citação é medida uma vez por mês.
A lista é versionada. A redação não muda entre as rodadas, e qualquer troca de pergunta vira uma lista nova, com data e registro no histórico de versões. Esta é a lista 1, válida a partir da publicação desta página. Até hoje, nenhum teste foi rodado com ela.
Para cliente, a regra é outra: na contratação, os prompts são escritos de forma personalizada, a partir do negócio, da oferta e do público dele, e seguem o mesmo registro datado. Como a nota, o resultado do cliente é privado.
4. Critérios
| Bloco | Critério | Aprovado | Parcial | Pendente |
|---|---|---|---|---|
| Indexação (10) | URLs do sitemap indexadas | ≥90% | ≥60% | <60% |
| Citação (5) | Respostas com citação da marca ou do site (sobre o total de respostas da rodada) | ≥50% | ≥20% | <20% ou sem teste |
Recomendação, fora da nota (decisão do Felipe, 16/10/2026): resposta direta e citabilidade (todo H1 em forma de pergunta respondido no primeiro parágrafo). Caso real (inspeção de 06/10/2026): 9 de 22 posts com H1 em pergunta não respondiam no primeiro parágrafo.
5. Como está no nosso site
- Indexação: a medir. O snapshot de 06/10/2026 foi parcial. Na remedição de 13/10, 6 inspeções de URL passaram com rastreio bem-sucedido, e o sitemap estava sem erros nem avisos.
- Desempenho orgânico (sem nota): 28 dias até 04/10/2026, 7 cliques, 1.010 impressões e posição média 7,5. Na semana de 05 a 11/10, 1 clique e 208 impressões, com a posição média indo de 7,2 para 12,8.
- Citação por IA: Pendente. Nenhum teste rodado até hoje.
- Visitas de assistentes (sem nota): 28 dias até 11/10/2026, 1 sessão de chatgpt.com e 7 de copilot.com.
6. Evidência autoral
O plugin de diagnóstico SEO/GEO que eu uso no laboratório é proprietário, não comercializado e sem código público. O registro de uma rodada dele no site ao vivo está publicado na Biblioteca.
7. Conteúdos que aplicam esta camada
- Registro: diagnóstico SEO/GEO no live felipecferreira.com.br (plugin 1.1.x, 08/08/2026).
- Plano de Mensuração de Eventos: o que Medir e em que Ordem, para ligar visita vinda de IA a contato e venda.
Transparência: o que Ainda Não Resolvemos
Antes de auditar o seu site, eu mostro o meu. Hoje, estas são as pendências abertas:
- INS-01 (C1): a origem (LiteSpeed da Hostinger, atrás da Cloudflare) devolve 429 ao GPTBot e ao meta-externalagent verificados, sem exceção possível. A trava de 70 segue ativa.
- Grafo (C6): linha de base de 25,0, com 53 órfãos e só 11 posts ligados ao pilar em 12/10. Estou corrigindo em lotes.
- Identidade (C5): Organization sem
sameAse Person com perfis antigos nosameAs. - Ofertas (C5): o Book do livro sem preço nem moeda na Offer.
/mapa/(C5 e C6): no sitemap, sem JSON-LD e fora do alcance pela home. Vai virar o KG Map FCF.- Metadados (C4): og:title da 7805 diferente do title.
- Desempenho (C2): sem Lighthouse nem Core Web Vitals medidos, por cota e pelo próprio INS-01.
- Citação (C8): nenhum teste rodado ainda.
- Critérios novos (C1, C3, C4, C7): HTTP para HTTPS, conteúdo sem JavaScript, indexabilidade coerente e versão para máquina na amostra completa ainda estão “a medir”.
- Agentes assinados: no plano Free, eles entram na contagem dos bots verificados desde 01/07/2026, e eu não consigo separá-los.
- Dados: a Cloudflare no plano Free amostra os números, e eu declaro isso ao lado de cada leitura.
Quando a nota global sai. Ela é publicada assim que esta documentação estiver fechada e todos os dados que o modelo de cálculo exige estiverem disponíveis. No mesmo dia, ficam públicos a nota, esta documentação e a página que explica como o cálculo é feito. A nota pode não ser alta, e vários pontos de melhoria vão ficar à vista. Isso faz parte do método: ela é auditável por qualquer pessoa. Até lá, publico as notas por camada que já têm linha de base e deixo o resto como “a medir”.
Histórico de Versões
As versões anteriores foram de testes internos e de laboratório. Esta documentação vale a partir da versão 3.1.0.
- v3.1.0 (16/10/2026): primeira versão pública da documentação. Nova seção “Quem Acessa o Seu Site: os Tipos de Acesso por Máquina” (crawler, fetcher acionado pelo usuário, Googlebot e Bingbot que renderizam, agente com navegador, automação headless e clique humano vindo de resposta de IA), com o efeito de cada um no método: C3 sem JavaScript mantido, HTML semântico para agentes com navegador, GA4 fora da nota (com a inferência sobre agentes com navegador declarada como tal) e a limitação dos agentes assinados no plano Free; limitação dos agentes assinados no plano Free da Cloudflare; retenção de 31 dias e nota mensal sobre a coleta semanal acumulada (desde 08/09/2026); CDN da Hostinger inativa no nosso site e incompatível com a Cloudflare. Fonte da afirmação sobre JavaScript na C3 (Google e Vercel) e da limitação de agentes assinados (Cloudflare) adicionadas às Referências. Datas honestas entrou na nota como critério da C4, e indexabilidade coerente foi confirmada nela (5 critérios, 2,00 pontos cada; 36 critérios no total), com a ressalva de que, no meu site, a gestão do sitemap é do Yoast SEO; resposta direta ficou como recomendação fora da nota. Teste de citação da C8 com a lista de exemplo de 6 prompts do meu site e prompts personalizados para cliente, na contratação; a porcentagem da citação é calculada sobre o total de respostas da rodada (prompt × assistente × dia). Schema:
isBasedOn→ Protocolo L0 : L7 (8178);citation→ fontes externas da Referências. - v3 (16/10/2026, testes internos e de laboratório): critérios definidos pela função, não pela marca; Cloudflare como caso e recomendação; critérios novos de DNS e TLS (C1), conteúdo sem JavaScript (C3), indexabilidade coerente (C4, proposto) e versão para máquina (C7); status ampliado na C3 (soft 404 e 301 que termina em 404); desempenho orgânico e GA4 fora da nota; recurso ausente vale 0; modelos de acesso; inspeção só com dado público tratada como outro produto; cadência mensal; nota de cliente privada; entrega ao cliente em página interativa (roteiro). 35 critérios.
- v2 (16/10/2026, testes internos e de laboratório): nome “Método de Inspeção GEO em 8 Camadas”; camadas com códigos C1 a C8 (C = camada), separados dos códigos L0 a L7 do Protocolo; C7 confirmada como Acesso por agentes de IA; critério sem medição conta como Pendente (0) e aparece como “a medir”; a atribuição da nota passa para uma página própria; chamada final reescrita.
- v1 (16/10/2026, testes internos e de laboratório): primeiro texto completo das 8 camadas, com estrutura fixa de 7 partes, passo a passo reproduzível, critérios e limites por camada, modelo de registro de evidência, explicação da nota e da trava do C1. KG-02 registrado como resolvido (114 de 114 artigos em 12/10, conferido por amostra ao vivo em 16/10). Remedição de 7 dias do INS-01 (13/10) incorporada.
- v0 (12/10/2026, testes internos e de laboratório): índice, texto da primeira camada e versão enxuta das camadas 2 a 8 (ainda com códigos L1 a L8). Decisões do Felipe: URL, formato, pesos, pontuação, trava de 70 e Protocolo L0 : L7 como base, sem redirecionamento.
Vamos Conversar?
Bom, espero que tenha ficado claro o que eu meço, como eu meço e por quê.
Se você chegou até aqui, este convite é para você. Pode ser para o seu próprio projeto, para a empresa onde você trabalha (como gestor ou como colaborador que precisa levar esse assunto para dentro de casa) ou, eventualmente, para outro profissional do mercado que quer trocar sobre método e evidência.
Se o seu site recebe visitas, mas você não sabe se o GPTBot consegue ler a página que te traz cliente, a conta começa por aí. Pense sempre no médio e longo prazo.
Quer entender como eu trabalho busca e autoridade, do Google às respostas de IA? Comece pelo pilar Busca e Autoridade.
E se quiser conversar direto comigo, me chame no WhatsApp. Vai ser um prazer falar contigo.
Referências
Ajuda do Google Analytics, exclusão de tráfego de bots conhecidos.
Google, especificação do robots.txt. Tratamento do 429 como erro de servidor.
Google Search Central, práticas recomendadas para links rastreáveis.
Google Search Central, introdução aos dados estruturados.
Google, Search Console API: Inspeção de URL.
Google, PageSpeed Insights API v5.
web.dev, Time to First Byte (TTFB). Faixas de referência.
web.dev, Core Web Vitals (LCP, INP e CLS). Faixas de referência.
W3C, Web Content Accessibility Guidelines (WCAG).
Cloudflare, GraphQL Analytics API.
OpenAI, documentação dos crawlers (GPTBot, OAI-SearchBot e ChatGPT-User).
llmstxt.org, proposta do arquivo llms.txt.
Schema.org, Schema Markup Validator.
Google, Teste de pesquisa aprimorada (Rich Results Test).
Experiência do autor: inspeções e medições no felipecferreira.com.br entre 06/10 e 16/10/2026.
Controle de versão
Primeira versão pública do Método de Inspeção GEO em 8 Camadas: 8 camadas, 36 critérios, passo a passo reproduzível, nota e trava do C1.